 We Manegit

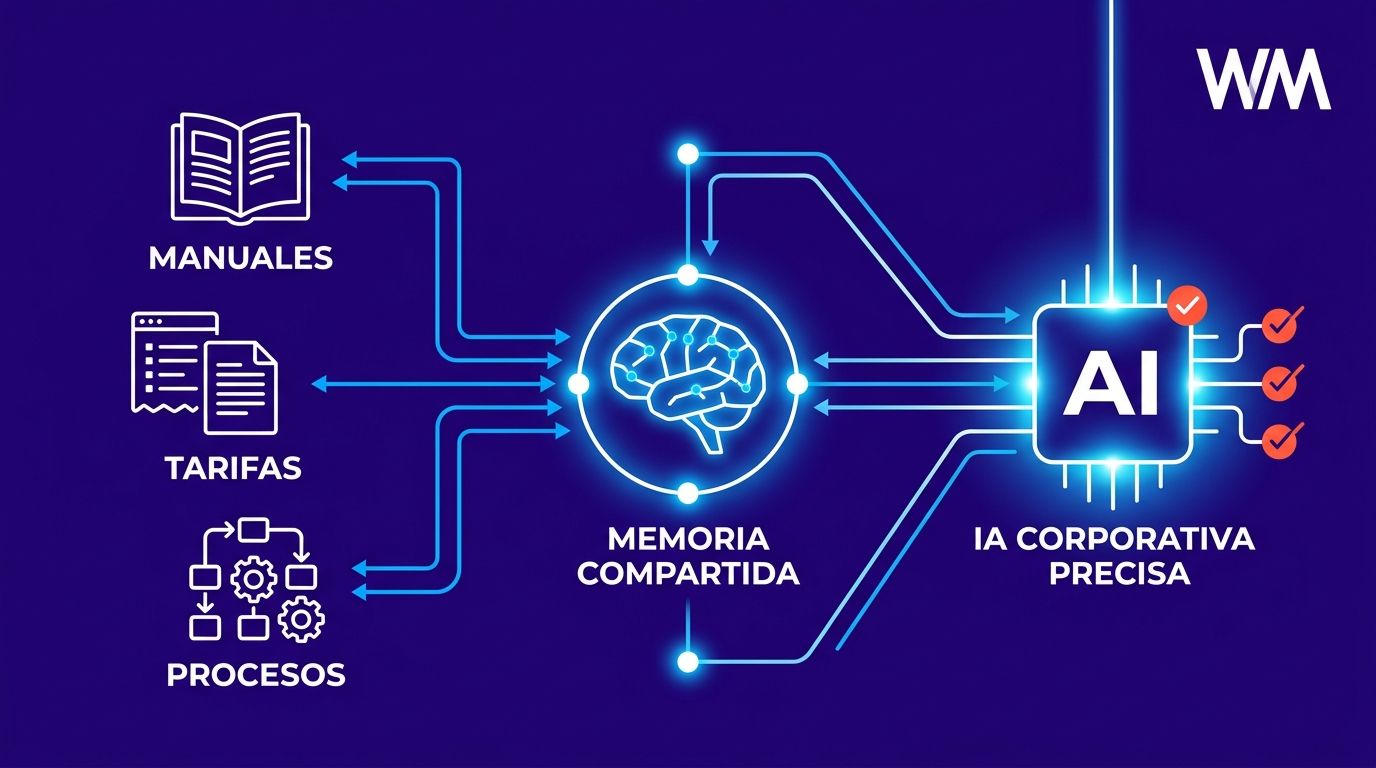
Resumen ejecutivo
La adopción de herramientas de inteligencia artificial en organizaciones medianas y empresas B2B suele atravesar una etapa temprana de entusiasmo que desemboca rápidamente en frustración: los modelos redactan con fluidez pero inventan condiciones comerciales, citan políticas de reembolso inexistentes, contradicen los precios vigentes o responden con un tono burocrático ajeno a la empresa. Este fenómeno no se debe a una falla del algoritmo, sino a un vacío estructural de contexto. Los modelos de lenguaje desconocen las operaciones internas de un negocio a menos que se los conecte a una memoria compartida: un repositorio centralizado, gobernado y actualizado que reúne las fuentes oficiales de verdad de la organización. Mediante arquitecturas de Generación Aumentada por Recuperación (RAG), la inteligencia artificial pasa de especular a consultar los manuales reales de la empresa antes de responder, con respuestas basadas en documentos que se pueden verificar.
1. La trampa del "prompt mágico": por qué la IA genérica falla en tu empresa
Durante los últimos tres años, la estrategia de adopción de inteligencia artificial en la mayoría de las organizaciones se limitó a un procedimiento rudimentario: contratar suscripciones de asistentes de IA de uso general y pedirle a los directivos, vendedores y analistas de soporte que escribieran instrucciones ("prompts") cada vez más detalladas para intentar obtener respuestas útiles.
La promesa inicial era atractiva: automatizar la elaboración de cotizaciones complejas, redactar respuestas personalizadas a reclamos técnicos y acelerar la inducción de nuevos colaboradores. No obstante, al llevar estos modelos a la práctica cotidiana de un negocio B2B, los resultados revelan inconsistencias críticas:
- El asistente propone plazos de entrega que la fábrica o el equipo de desarrollo jamás comprometió.
- Inventa condiciones de garantía extendida o aprueba excepciones de pago que violan las directivas financieras de la dirección.
- Aplica un tono genérico, excesivamente condescendiente o repleto de clichés corporativos que destruyen la identidad de la marca.
- Dos ejecutivos comerciales ingresan la misma consulta respecto al alcance de un servicio y obtienen propuestas con alcances y tarifas totalmente contradictorias.
La reacción habitual de los equipos consiste en culpar a la redacción de la orden: "Necesitamos un prompt más largo, con más reglas y mejores ejemplos". Sin embargo, intentar resolver la precisión operativa a través de prompts kilométricos es un error de arquitectura conceptual. Un modelo de lenguaje comercial (Large Language Model o LLM) ha sido entrenado para predecir la palabra estadísticamente más probable a partir de una inmensa masa de texto público de internet. Sabe cómo estructurar un memorando, cómo programar en Python y cómo razonar lógicamente sobre problemas abstractos; pero no tiene forma de saber cuál es el protocolo de tu empresa ante una rotura de stock en 2026, qué clientes tienen descuentos por volumen o cuál es el procedimiento exacto de escalamiento técnico.
Exigirle a un modelo de inteligencia artificial que atienda consultas de clientes o redacte contratos comerciales sin conectarlo a la memoria documental de la empresa equivale a contratar al profesional con el mejor promedio universitario del país y sentarlo a responder llamadas en su primer día de trabajo, sin haberle entregado un manual de inducción, sin acceso al sistema de gestión y con las carpetas de antecedentes bajo llave. Por más talento que posea el empleado, se verá obligado a improvisar. En inteligencia artificial, esa improvisación tiene un nombre técnico: alucinación.
2. Glosario clave: de las alucinaciones a la Generación Aumentada por Recuperación (RAG)
Para estructurar la gestión de conocimiento y la automatización con IA bajo estándares de ingeniería y gobernanza corporativa, es indispensable dominar estos conceptos fundamentales:
- Alucinación (AI Hallucination)
- Comportamiento en el cual un modelo de lenguaje produce una respuesta con total elocuencia, coherencia sintáctica y seguridad discursiva, pero que resulta ser fácticamente falsa, desactualizada o basada en supuestos inventados por el propio modelo.
- Memoria compartida (cerebro corporativo)
- Sistema unificado, estructurado y gobernado donde residen las fuentes oficiales de verdad de una empresa: manuales de procedimiento, especificaciones técnicas de productos, matrices de precios, actas de acuerdos de directorio y políticas de servicio.
- RAG (Retrieval-Augmented Generation)
- Marco de arquitectura computacional que condiciona la respuesta del modelo de IA a una búsqueda previa de información: el sistema extrae primero los fragmentos relevantes de la memoria privada de la empresa y se los entrega al modelo como único material de consulta habilitado para redactar la respuesta.
- Embeddings vectoriales
- Representación matemática de fragmentos de texto en un espacio multidimensional que captura el significado semántico y las relaciones conceptuales entre palabras, permitiendo encontrar información por sentido y contexto, y no solo por coincidencias literales de términos.
- Ventana de contexto (Context Window)
- La capacidad máxima de procesamiento de datos simultáneos (medida en tokens o unidades de texto) que un modelo de IA puede mantener activa en una conversación. Aunque las ventanas han crecido, saturarlas con documentos desordenados provoca pérdida de atención (Lost in the Middle).
- Silo de información
- Aislamiento operativo donde el conocimiento estratégico de un negocio queda retenido en computadoras personales, buzones de correo individuales, notas de reuniones en libretas o exclusivamente en la memoria de colaboradores antiguos.
3. Qué es la memoria compartida: el fin del conocimiento fragmentado en silos
En la inmensa mayoría de las organizaciones en vías de escalamiento, el conocimiento de la empresa no existe como un activo estructurado; existe como una dispersión caótica de fragmentos distribuidos sin control.
La anatomía del desorden: dónde vive hoy el conocimiento en una PyME
Al revisar los flujos de trabajo de una empresa de servicios o manufactura B2B, es común encontrar que las decisiones operativas descansan en canales precarios:
- La última versión de la lista de precios y condiciones de descuento reside en una planilla de cálculo guardada en el disco local de la jefa de ventas.
- El criterio para resolver una incidencia técnica compleja solo lo conoce el programador o técnico de mayor antigüedad, quien responde verbalmente o mediante mensajes efímeros de WhatsApp.
- Los contratos marco y las cláusulas especiales acordadas con clientes clave están enterrados en cadenas de correos electrónicos de ejecutivos que ya no pertenecen a la compañía.
- Los lineamientos de identidad visual y tono de voz corporativo jamás se bajaron a un documento formal, y se transmiten por intuición o imitación.
Este desorden hace que buena parte de la jornada de los mandos medios se consuma respondiendo internamente las mismas preguntas una y otra vez: "¿Cuánto cobramos por este servicio adicional?", "¿Podemos entregar en quince días?", "¿Qué hacemos si el cliente pide rescisión anticipada?". Cuando el colaborador que atesora esas respuestas renuncia, se enferma o se toma vacaciones, la empresa sufre una parálisis operativa inmediata.
De repositorio pasivo a cerebro corporativo activo
Una memoria compartida no es simplemente una carpeta compartida en Google Drive, OneDrive o SharePoint repleta de archivos en formatos heterogéneos (PDF escaneados sin texto reconocible, notas de Word desactualizadas y hojas de cálculo sin rotular). Eso es un cementerio documental pasivo donde nadie encuentra nada.
Una memoria compartida corporativa constituye un sistema estructurado, curado y vivo que cumple con tres condiciones indispensables:
- Unicidad de la verdad: existe un único documento oficial para cada proceso, producto o política. Si un procedimiento se actualiza, la versión anterior se archiva y la nueva se propaga a todos los puntos de consulta.
- Estructura legible por máquinas y humanos: la información se documenta en formatos limpios (como Markdown estructurado con títulos claros, listas y tablas), evitando ambigüedades, dobles sentidos y contradicciones internas.
- Gobierno de acceso y actualización continua: cada documento cuenta con un responsable asignado (Owner) que valida su vigencia y un protocolo de permisos que determina quién puede consultar, editar o revisar cada módulo de información.
Cuando este cerebro corporativo se consolida, cumple dos funciones estratégicas inmediatas: permite que una persona nueva gane autonomía mucho más rápido sin interrumpir a sus compañeros, y proporciona la base de datos limpia e indispensable para que cualquier herramienta de inteligencia artificial responda con precisión.
4. Cómo interactúa un modelo de lenguaje con la memoria de tu negocio (paso a paso técnico)
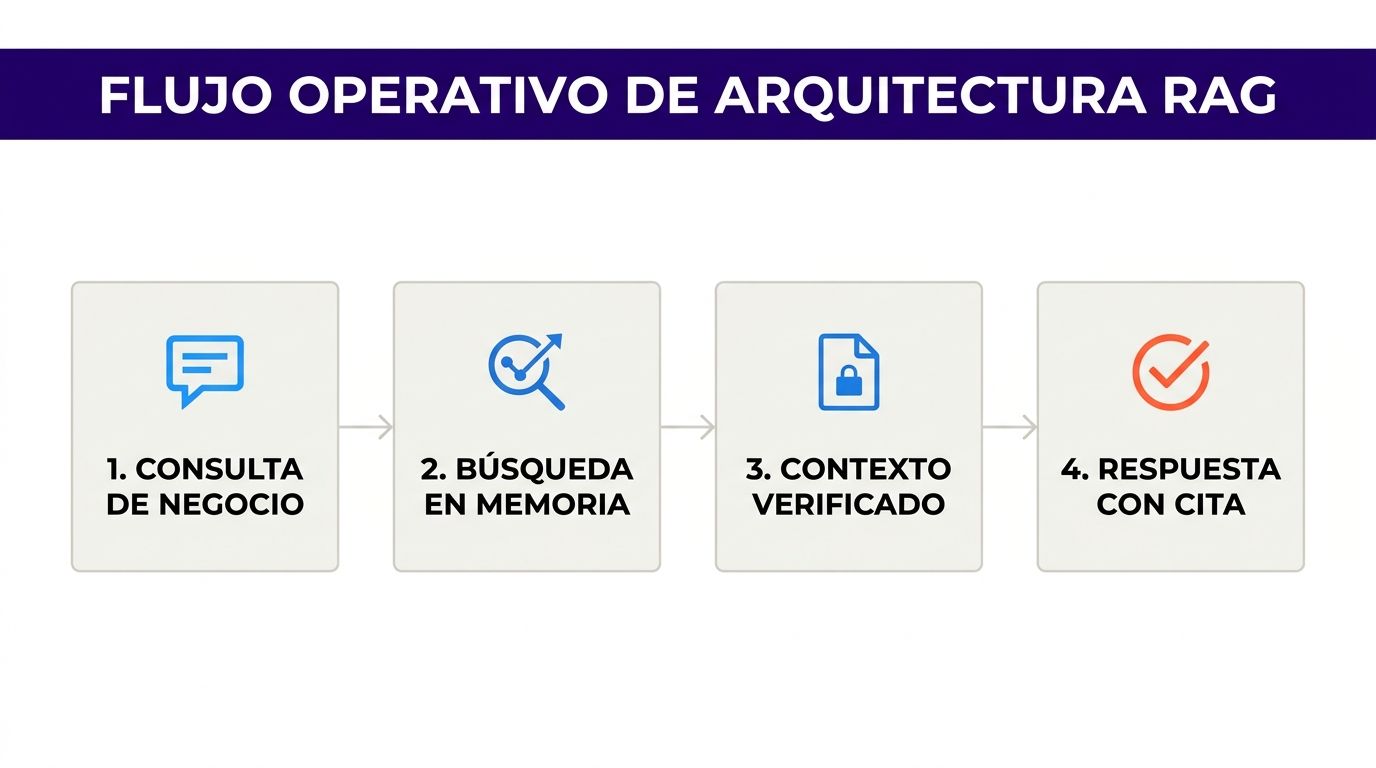
Para lograr que una IA responda sobre los procesos de tu negocio sin equivocarse, no se reentrena el modelo base (lo cual requeriría millones de dólares y meses de computación). En su lugar, se implementa una arquitectura de Generación Aumentada por Recuperación (RAG) que conecta el modelo con la memoria compartida mediante un proceso técnico en cuatro fases:
Fase 1. Ingesta, limpieza y desambiguación documental
El proceso comienza en la fase editorial: los manuales de procedimientos, contratos tipo, descripciones de servicio y matrices operativas se recopilan y se limpian de contradicciones. Si el manual técnico de 2024 afirmaba que el soporte se brindaba en 4 horas, pero la política de 2026 establece un plazo de 2 horas hábiles, la contradicción debe resolverse antes de que la máquina la lea. Los documentos se formatean bajo un estándar semántico riguroso con etiquetas de metadatos (fecha de vigencia, departamento responsable y nivel de confidencialidad).
Fase 2. Indexación y fragmentación semántica (chunking y embeddings)
Un modelo de IA no puede procesar un manual de 300 páginas de una sola vez de forma eficiente. Por ello, el sistema divide los documentos en unidades lógicas de información denominadas fragmentos (chunks), compuestas habitualmente por párrafos de entre 200 y 500 palabras que conservan una idea completa (por ejemplo, una política específica de facturación o el procedimiento de configuración de un registro DNS).
Cada uno de estos fragmentos pasa por un modelo de embeddings que lo transforma en un vector: una serie de números que describe conceptualmente su contenido. Estos vectores se almacenan en una base de datos vectorial especializada, que indexa el conocimiento por afinidad semántica.
Fase 3. Búsqueda contextual y recuperación en milisegundos
Cuando un miembro del equipo le formula una consulta al sistema (por ejemplo: "¿Qué penalización aplica si un cliente del plan corporativo cancela el servicio antes del mes 6?"), el sistema convierte la pregunta del usuario en un vector matemático.
En milisegundos, el motor vectorial compara el vector de la pregunta con los vectores almacenados en la memoria compartida de la empresa y rescata los dos o tres fragmentos del contrato o manual donde se detalla la política de penalización por rescisión anticipada.
Fase 4. Generación condicionada con anclaje estricto
El sistema toma la pregunta del usuario, toma los fragmentos oficiales recuperados de la memoria y los empaqueta dentro de una plantilla de instrucción del sistema (system prompt) diseñada bajo directivas de estricto anclaje en los hechos. Una plantilla típica tiene cuatro partes:
- Rol: "Eres el asistente operativo oficial de la empresa".
- Contexto obligatorio: "Utiliza exclusivamente los siguientes fragmentos extraídos de la memoria compartida de la empresa para responder la pregunta del usuario", seguido de los fragmentos recuperados (por ejemplo, la cláusula del manual de contratos vigente sobre cancelaciones anticipadas).
- Reglas de respuesta: responder de forma concisa, profesional y directa, y citar la fuente exacta del documento al pie de la respuesta.
- Qué hacer si falta el dato: si la respuesta no está explícitamente en el contexto suministrado, responder textualmente "Esa información no se encuentra en los manuales oficiales de la empresa; por favor escala la consulta con la dirección de operaciones". Queda prohibido suponer, deducir o inventar información que no figure en los fragmentos.
Bajo este esquema, el modelo de lenguaje actúa como un sintetizador y redactor de la información que la propia empresa le suministró en ese segundo. El riesgo de alucinación se reduce al mínimo y la respuesta cuenta con un respaldo documental que se puede revisar.
5. Diagnóstico y comparativa: IA aislada sin contexto vs. IA conectada a la memoria compartida con AIM
| Factor | IA genérica sin contexto (uso tradicional) | IA conectada a la memoria compartida con AIM (We Manegit) |
|---|---|---|
| Fuente de información | Conocimiento público de internet con corte temporal previo. | Documentos oficiales, procesos vigentes y tarifas de tu empresa. |
| Riesgo de alucinación | Alto: inventa datos verosímiles ante preguntas de negocio. | Bajo: responde con los documentos revisados de tu empresa y avisa cuando el dato no está. |
| Criterio comercial y tono | Respuestas genéricas que no reflejan tu propuesta de valor. | Respuestas coherentes con tus políticas y tu tono de marca. |
| Continuidad ante renuncias | Si el colaborador con antigüedad renuncia, el conocimiento se pierde. | El conocimiento queda en la empresa, ordenado y disponible para todos. |
| Trazabilidad | Imposible de revisar: el modelo no cita fuentes verificables. | Cada respuesta puede indicar el documento del que sale. |
| Gobernanza de acceso | Los colaboradores suben archivos dispersos en cuentas privadas. | Cuentas a nombre de la empresa y una política de uso que define qué datos se cargan. |
| Mantenimiento | Cada usuario debe reescribir prompts y pegar contexto manualmente. | Tu AIM mantiene el cerebro de la empresa y los asistentes al día cada mes. |
6. Preguntas frecuentes sobre implementación de IA, bases de conocimiento y privacidad
¿Conectar la IA a los documentos de mi empresa expone información confidencial o alimenta modelos públicos de terceros?
Es la preocupación más legítima de cualquier director general o responsable legal, y la respuesta depende de la vía de conexión. Si los empleados usan versiones personales o de consumo de los asistentes de IA, los términos de servicio suelen permitir que las conversaciones se usen para entrenar los modelos, lo que es una brecha de confidencialidad comercial. Con planes empresariales o acceso por API, los proveedores suelen comprometerse por contrato a no usar tus datos para entrenamiento. En AIM, las licencias de la herramienta de IA quedan a nombre de tu empresa, la política de uso define qué datos se pueden cargar y alguien senior revisa toda conexión con datos de clientes antes de activarla.
¿Por qué no basta con subir los archivos de la empresa directamente a una ventana de chat de un asistente de IA?
Cargar archivos PDF en una ventana de chat sirve para una tarea aislada de un empleado, pero no funciona como sistema de gestión por cuatro motivos. Falta gobierno de versiones: si tres vendedores suben sus propias versiones de un catálogo, cada uno obtendrá respuestas distintas basadas en documentos que pueden estar desactualizados hace seis meses. Hay límites de atención: con manuales extensos o decenas de documentos, el modelo empieza a omitir cláusulas intermedias y a mezclar párrafos de documentos diferentes. Se pierde tiempo: cada empleado tiene que buscar, seleccionar y subir los archivos correctos en cada sesión. Y no hay control directivo: la empresa no ve qué documentos se consultan, qué dudas se repiten ni qué políticas tienen vacíos.
¿Qué tipo de información debe formar parte de la memoria compartida inicial y cuál debe excluirse?
Conviene construirla de forma progresiva, empezando por el conocimiento de alta repetición y fricción comercial: fichas de productos y servicios (alcances, requisitos previos, limitaciones y plazos de implementación), el manual de objeciones comerciales y preguntas frecuentes de prospectos, los acuerdos de nivel de servicio y políticas de posventa (tiempos de respuesta, garantías, devoluciones y canales de escalamiento) y las directrices de identidad verbal (tono, términos prohibidos y estructura de las propuestas). Por seguridad y por el principio de menor privilegio, deben quedar fuera los balances contables detallados, las nóminas salariales, las contraseñas de infraestructura y los datos personales sensibles de clientes.
¿Cómo ayuda el servicio AIM de We Manegit a las empresas con este desafío?
Tu AIM ordena lo que sabe tu empresa en un cerebro central (servicios, precios, procesos y decisiones en un solo lugar), configura asistentes de IA para tareas concretas que lo leen antes de responder y los mantiene al día cada mes. Además, define una política de uso y capacita a tu equipo. Alguien senior revisa toda conexión con datos de clientes antes de activarla, tu empresa decide qué tareas pasan a la IA y las licencias quedan a su nombre.
Convierte el desorden de tus archivos en la memoria oficial de tu negocio
Cuéntanos dónde vive hoy el conocimiento de tu empresa y cómo usa la IA tu equipo. Revisamos dónde están tus documentos, precios y procesos, y te respondemos con el próximo paso para ordenarlos en un cerebro central que tus asistentes de IA consulten antes de responder.
Hablemos